假設您拍了一張教室照片:前方是講桌,旁邊有幾排座椅。如果請 AI 帶我們繞到講桌後面,它可能真的生成一段流暢的影片,連原本沒拍到的角落都出現了。這時,一個問題值得停下來想:它知道那裡原本長什麼樣,還是補出了一個看起來合理的版本?
2026 年 9 月,李飛飛與 World Labs 團隊在 Podcast 談到世界模型 Atlas,核心題目是「換一個位置,會看到什麼」。團隊同月公布的技術展示,讓我們有機會把「空間智慧」這個名詞,放到具體畫面裡理解。
先記住一個重點:生成得很像,不代表每個細節都曾被相機拍到。接下來,我們就從照片裡的線索,一路看到機器人為什麼需要這項能力。
空間智慧:認出杯子之後,還要知道怎麼拿
看見桌上有杯子,與知道杯子在桌邊、把手朝哪裡、伸手會不會撞到旁邊的東西,是不同層次的問題。史丹佛 HAI 對空間智慧(spatial intelligence)的說明,包含理解立體世界中的物體關係、移動與互動;放進 AI,就是讓系統能感知並推理所在環境。
對一般讀者而言,可以先把世界模型(world model)理解為:AI 建立一份環境的內部表示,用來預測換個視角,或做出某個動作後,接下來可能出現什麼。不同研究對這個名稱的用法並不完全相同;有的重在生成畫面,有的重在模擬動作後果。
Atlas 怎麼補出新視角?先看輸入與輸出
依團隊技術說明,Atlas 可以接收照片,搭配指定的相機位置與方向,生成從其他角度觀看的畫面;它也能處理深度等空間資訊,輸出立體場景表示。這項任務常稱為新視角合成:要改變的是觀看位置,同一個場景裡的物體關係則應盡量維持一致。
「相機位置」可以想成我們站在哪裡,「方向」就是朝哪裡看。若從教室門口走向窗邊,講桌在畫面中的位置、遮住座椅的範圍,都會改變。模型需要處理這些關係,才能讓畫面像是在同一個空間裡移動。這是本站依相機控制機制補充的教室例子。
延伸觀看|到 World Labs 官方頁面看 Atlas 展示
World Labs 在 Atlas 官方技術說明頁 放有生成、重建與模擬的展示影片與互動範例。觀看時可以留意:視角改變時,場景結構是否延續;這些是團隊選出的展示案例,不是一鏡到底的現場實拍,也不是獨立測試。
沒有拍到的背面,合理不等於真實
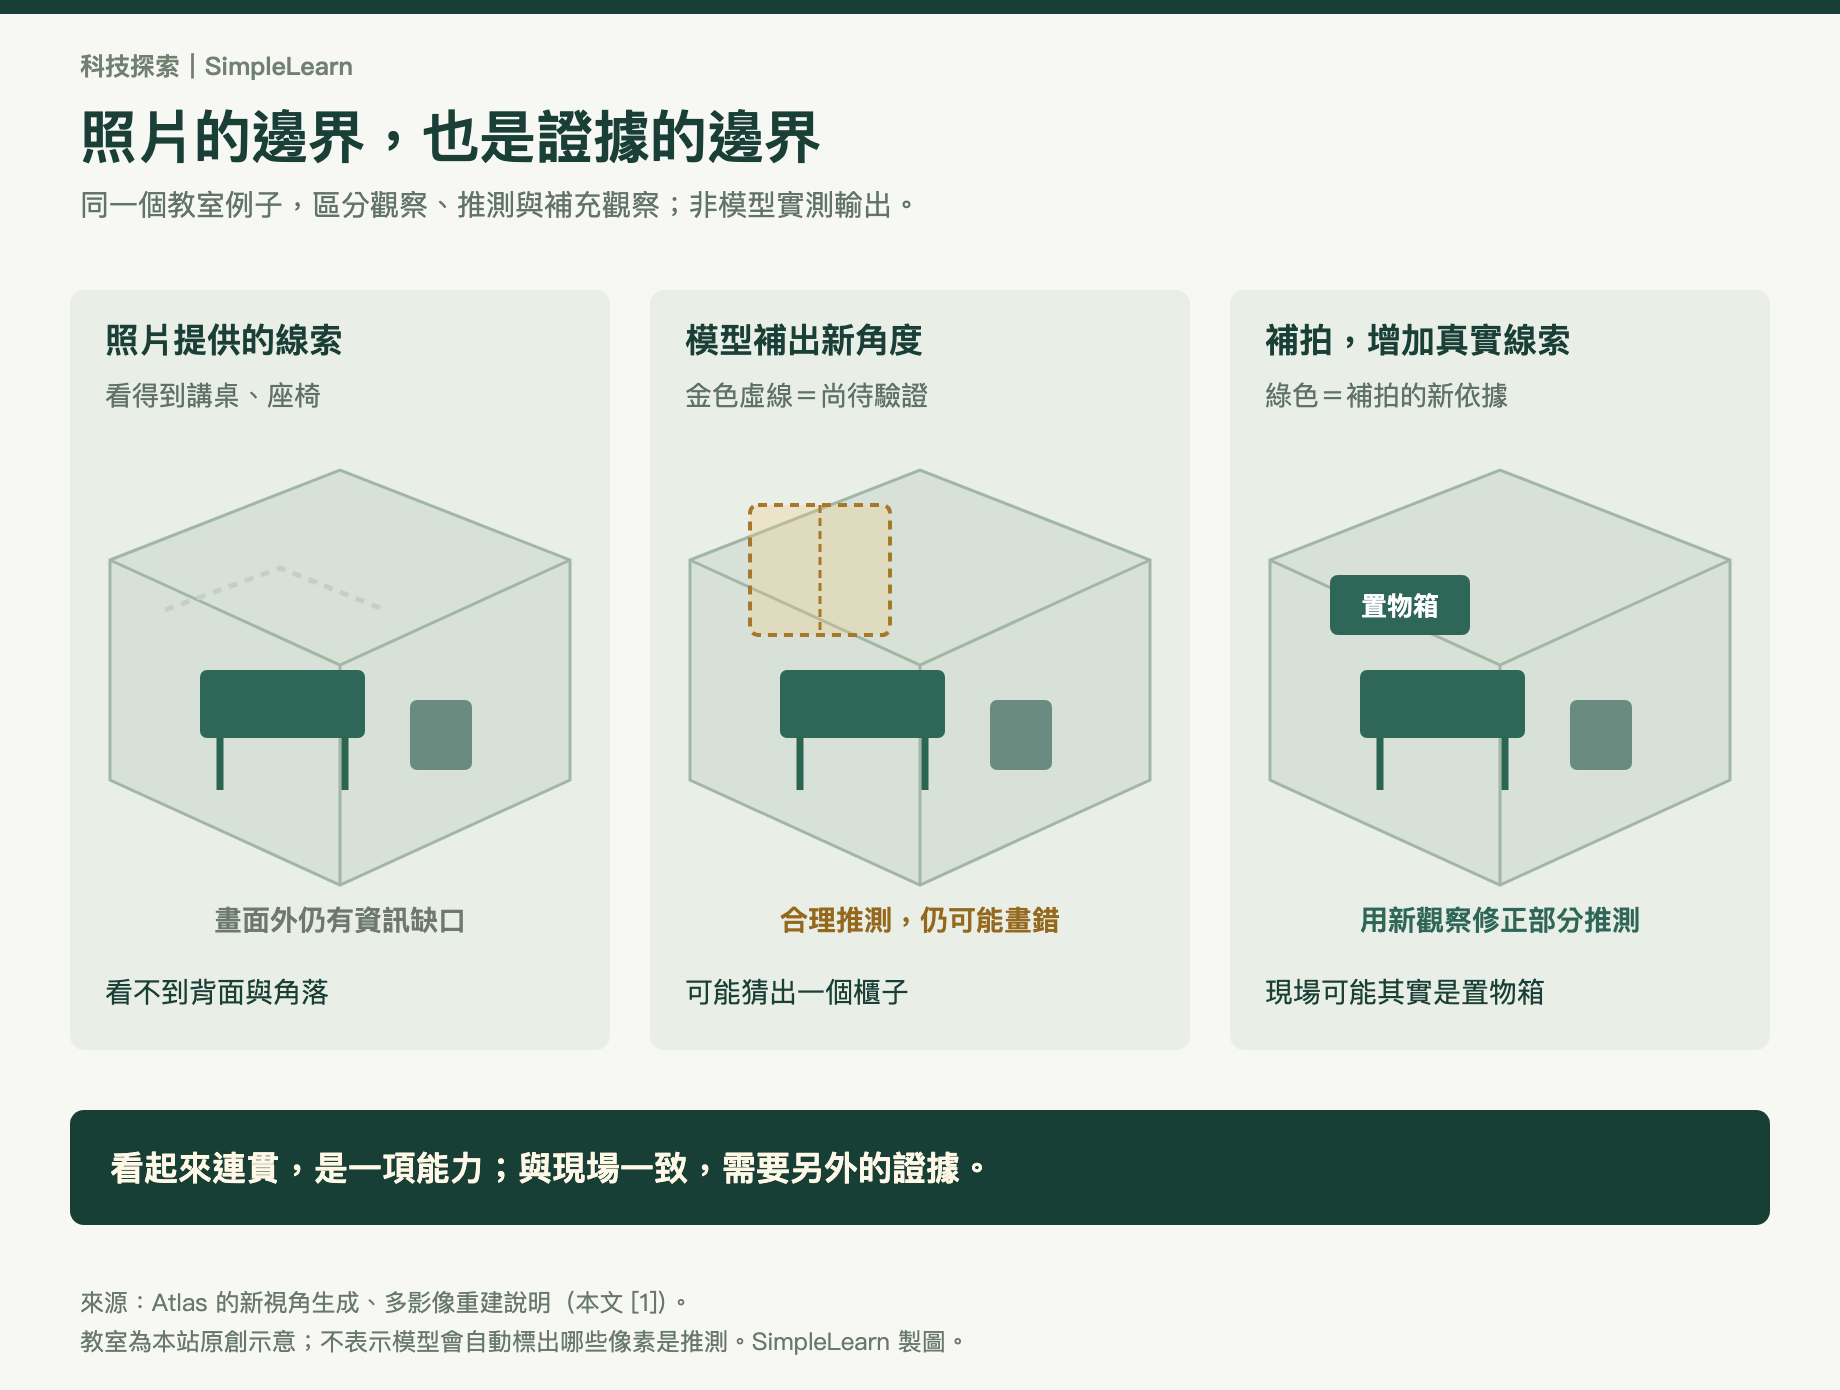
照片提供的資訊有邊界。拍到櫃子正面,未必知道背面有沒有破損;看到桌面,也不一定知道桌下藏著什麼。Atlas 的官方說明明確指出:對沒有出現在輸入影像中的區域,模型會生成合理的內容。補進更多實際照片,可以提供更多約束,但不能直接把所有輸出當成量測紀錄。
本站補充比喻|看照片畫一張地圖
想像請一位畫圖的人,依門口拍到的照片畫教室平面圖。他可以利用看得見的桌椅安排,推測後面還有走道;但照片沒拍到的地方,畫得合理也可能畫錯。再補一張從窗邊拍的照片,就能修正部分猜測。這個比喻依「稀少視角提供有限約束、未見區域需要推測」的機制延伸;AI 的運作並不是人在腦中畫圖,也不表示它具有人的空間理解。
做出畫面、模擬後果、決定動作,分別需要什麼?
李飛飛與團隊在另一篇文章中,提出一種功能分類:產生觀察畫面的 renderer、模擬環境狀態的 simulator,以及決定下一步動作的 planner。這是團隊用來釐清討論的分類方式,不是所有研究都採用的唯一標準。
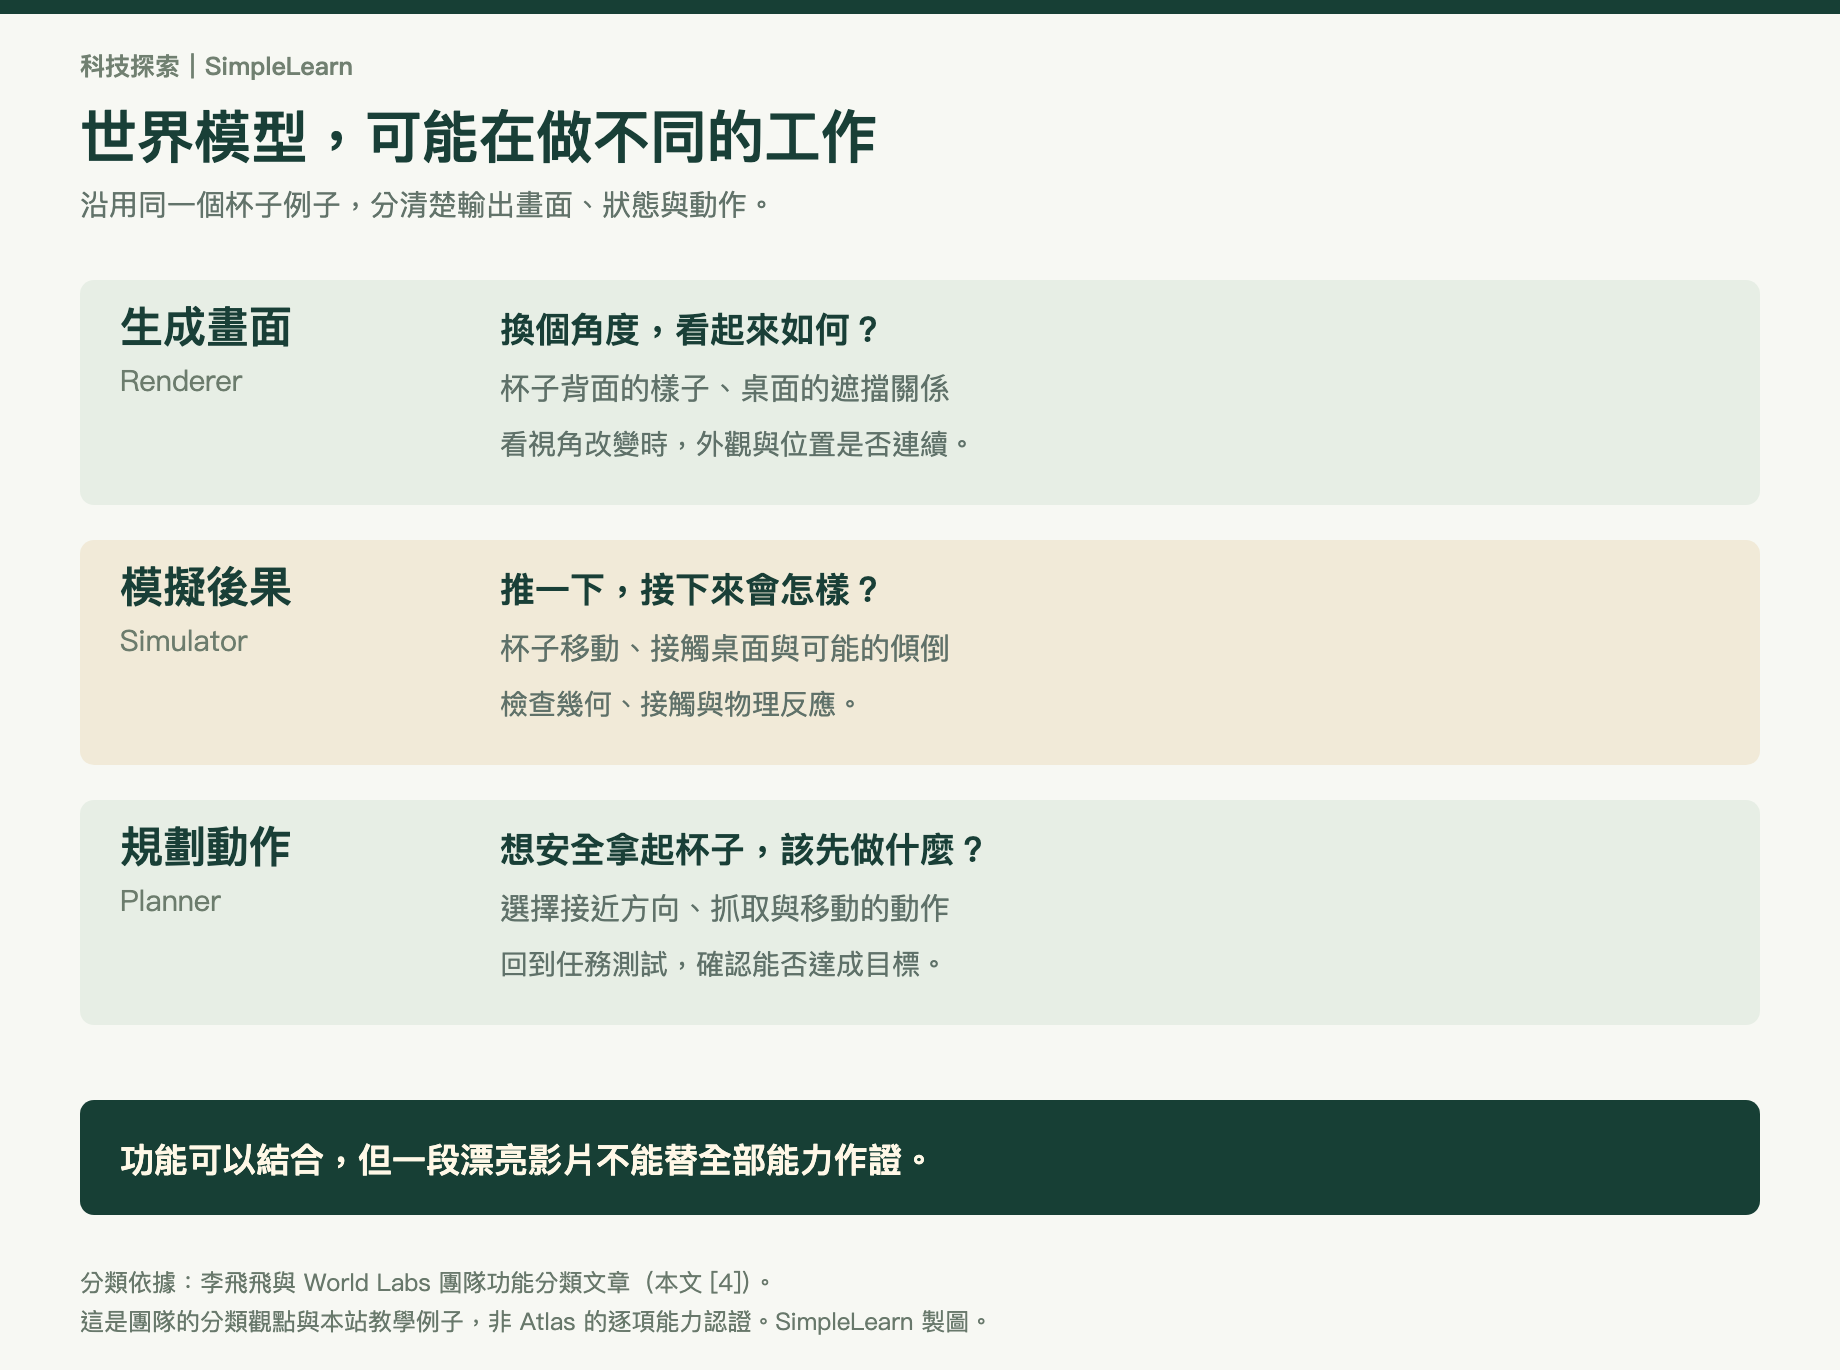
例如,杯子後方的花紋畫得很自然,是視覺上的進展。推杯子時,它是否會依桌面摩擦、杯子的形狀而合理移動,則是另一個檢驗。至於機器人要選哪個抓取角度,還涉及規劃與控制。這些功能可以結合,但不能只憑一段流暢影片,就認定後面的能力都已到位。這是本站依上述分類整理的閱讀判斷。
為什麼和機器人有關?它需要能拿來練習的環境
世界模型並不是最近才出現的想法。Ha 與 Schmidhuber 在 2018 年的研究,就探索讓代理系統在學到的模擬環境中練習,再回到原本的遊戲環境測試。那是受控遊戲任務,不能直接等同於現在的家庭機器人,但能幫助我們理解「先在模型裡試,再回到環境驗證」的研究方向。
把這個方向放到機器人身上,問題就更具體了:椅子挪開、光線變暗、物品換了位置,它還能完成任務嗎?虛擬環境有機會提供反覆練習與測試的條件;但若模擬把距離、接觸或物體反應弄錯,練得熟也可能無法順利用在實體設備上。
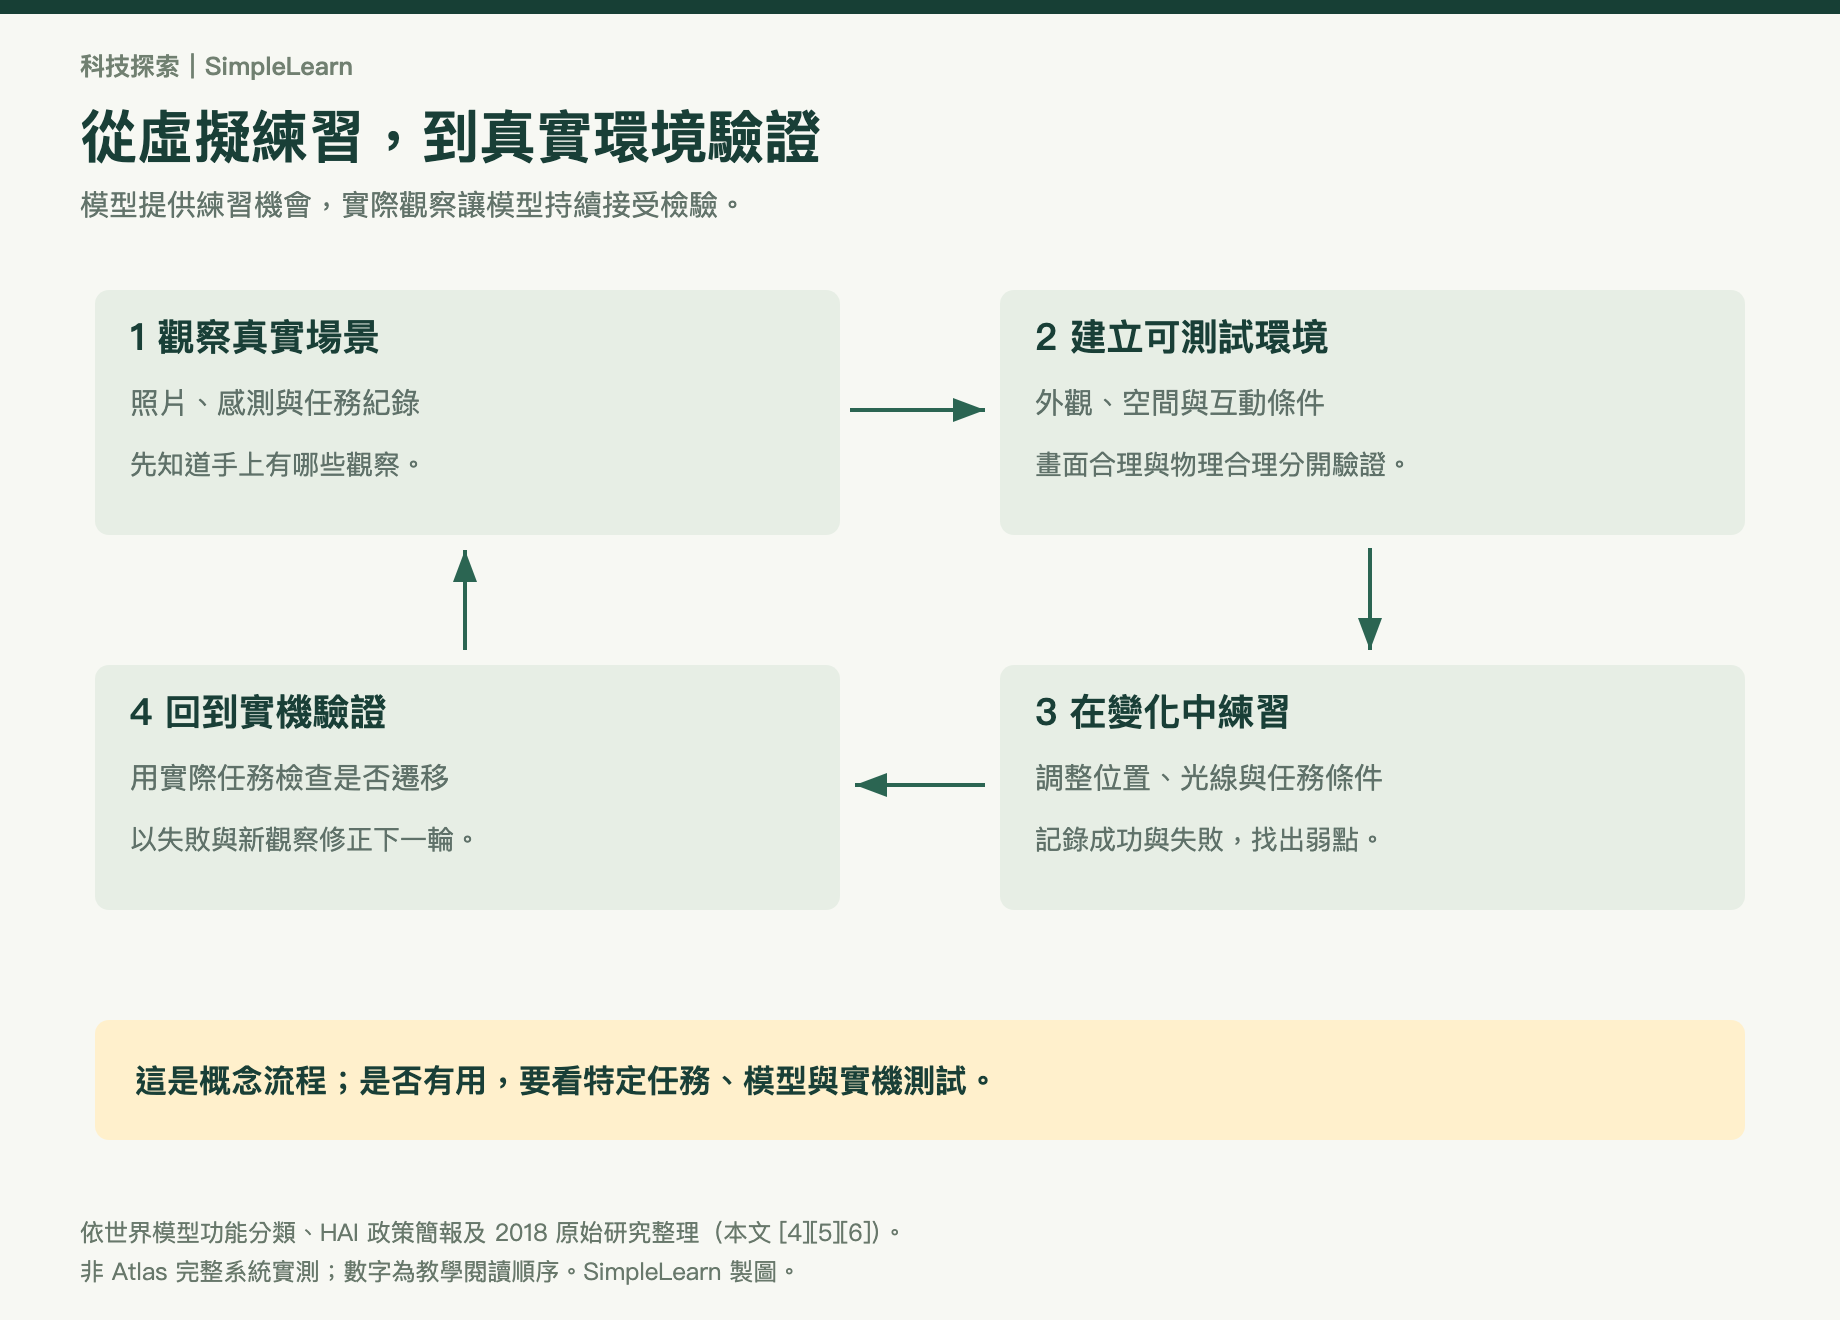
讀展示時,把證據補成完整句子
史丹佛 HAI 的世界模型政策簡報提醒,安全攸關的部署仍缺乏足夠的評估基礎;重要的問題是,模擬是否真的貼近所要訓練或測試的現實情境。因此,應用在動畫創作與應用在會移動的機器人上,證據要求會不同。
| 看到的展示 | 可以先確認什麼 | 還不能直接推論什麼 |
|---|---|---|
| 相機換角度,畫面連續 | 模型能在展示條件下生成相連視角 | 所有未拍到的細節都符合現場 |
| 場景能在螢幕上探索 | 輸出能用於某種視覺探索 | 距離、碰撞與材質反應都已驗證 |
| 機器人在模擬中完成任務 | 特定模擬與任務下的表現 | 換到實機、陌生房間也同樣可靠 |
本站延伸活動|找出照片沒告訴你的事
拿一張自己拍、沒有個資的房間照片,先列出能直接看見的物件,再列出需要換角度才知道的細節。例如「椅子在桌旁」有影像線索,「桌後一定有插座」則需要更多證據。若再看 AI 生成的新角度,可以把推測與可驗證的部分分開記錄。這是依本文機制設計的觀察活動,未做教學成效測試。
對父母、老師與學生來說,這項發展最值得帶走的,是一個可反覆使用的判斷:畫面能帶我們走到看不見的地方;要知道那裡是否真的如此,還需要觀察與驗證。這也讓「世界模型」從一個新名詞,變成理解 AI 能力與界線的入口。
延伸觀看|李飛飛與團隊談 Atlas
參考來源
- World Labs:Atlas: A World Model for Spatial Intelligence(2026-09-01)
https://www.worldlabs.ai/blog/atlas - a16z:Fei Fei Li: The Race to Build World Models For AI(2026-09-04)
https://a16z.com/podcast/fei-fei-li-the-race-to-build-world-models-for-ai/ - a16z/YouTube:Why Fei-Fei Li Is Betting on Spatial Intelligence(2026-09-04)
https://www.youtube.com/watch?v=qn1QDDBnTA0 - Stanford HAI:What is Spatial Intelligence?(查閱 2026-10-26)
https://hai.stanford.edu/ai-definitions/what-is-spatial-intelligence - World Labs:A Functional Taxonomy of World Models(2026-06-03)
https://www.worldlabs.ai/blog/taxonomy-of-world-models - Stanford HAI:The World Model and Spatial Intelligence Era: Governing AI Beyond Language(2026-07-27)
https://hai.stanford.edu/policy/the-world-model-and-spatial-intelligence-era-governing-ai-beyond-language - Ha、Schmidhuber:World Models(2018-03-27)
https://worldmodels.github.io/
本文由 AI 協助整理,經編輯審閱。