
這個專案將引導初學者透過使用 TensorFlow 框架,對 Fashion MNIST 數據集進行圖像識別的深度學習模型的設計、開發和評估,並且可以試著將模型下載分享與視覺化模型架構。從基礎理論到實務操作,本專案旨在為初學者逐步了解深度學習的過程,並且帶領讀者從數據預處理到模型訓練和評估,進而掌握如何在實際情境中應用深度學習模型。
- 專案目的:幫助初學者透過對 Fashion MNIST 數據集進行圖像識別的深度學習模型的設計、開發、評估逐步了解深度學習的過程。並且學習如何將模型下載分享與及視覺化模型架構。
- 開發環境:可參考在 Google Colab 或 Jupyter Notebook 開發環境中練習。
- 使用環境:桌機或NB
- 參考資料:【從 AI 到 生成式 AI:40 個零程式的實作體驗,培養新世代人工智慧素養】 觀念講解,Python for Beginners 、Matplotlib for Beginners、Hello Matplotlib 程式講解。
1. 學習目標
- 瞭解深度學習(Deep Learning)和神經網路(Neural Networks)的基本概念。
- 掌握使用 TensorFlow 進行進行數據處理、模型建構、訓練和評估的技巧。
- 學會進行數據正規化和模型參數的調整。
- 實作建構、訓練和評估深度學習模型。
- 提升問題解決和模型優化的能力。
2. 步驟說明
Step 1. 數據載入及預處理
- 載入數據集:使用 TensorFlow 的 Keras API 載入 Fashion MNIST 數據集,這是一個常提供給初學者使用的深度學習圖像分類數據集。是由 60,000 個圖像的訓練集(training set)和 10,000 個圖像的測試集(test set)所組成。每個圖像都是一個 28×28 灰階影像,與 10 個類別的標籤相關聯。
import tensorflow as tf

mnist = tf.keras.datasets.fashion_mnist

(training_images, training_labels), (test_images, test_labels) = mnist.load_data()
Step 2. 顯示第一個訓練圖像
備註:本步驟提供想學習查看訓練資料圖像內容的讀者參考,若不需要則可以考慮跳至下一個步驟,不會影響本專案學習。
- 導入 matplotlib 函式庫來顯示圖像
import matplotlib.pyplot as plt- 顯示第一個訓練圖像
plt.imshow(training_images[0])
- 列印訓練標籤及圖像
print(training_labels[0]) # 列印第一個訓練標籤9
輸出類別 9 即為 Ankle boot,其他類別可參考下表。

print(training_images[0]) # 列印第一個訓練圖像的像素數據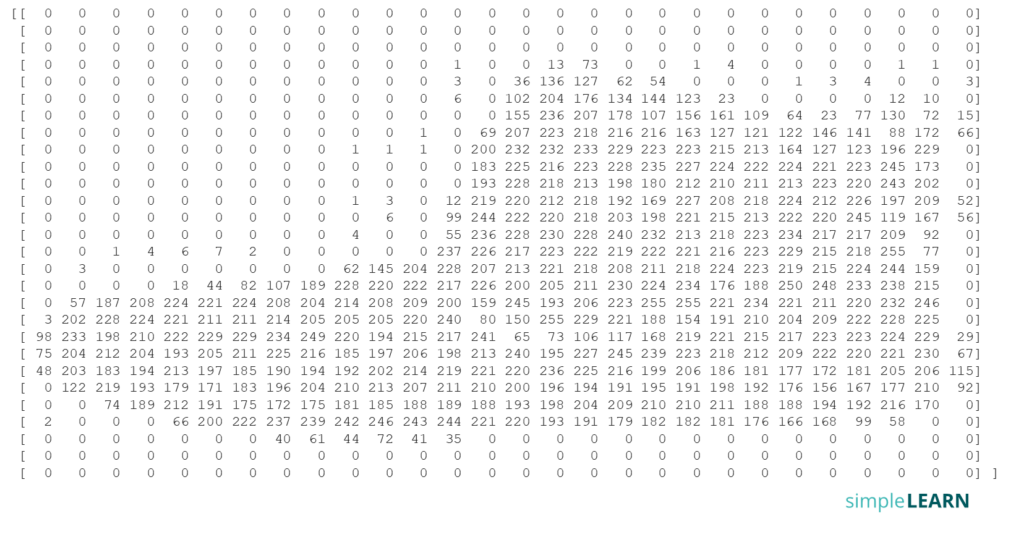
Step 3. 數據正規化
- 數據正規化:將圖像數據的像素值縮放到 0 到 1 之間,可以幫助模型更快更好地學習。
training_images = training_images / 255.0
test_images = test_images / 255.0
Step 4. 定義模型結構
- 設計神經網路結構:使用
Sequential模型來堆疊層(Layer)。首先是平坦層(Flatten Layer)將二維圖像轉換為一維陣列圖像數據,然後是兩個密集層(Dense Layer)進行特徵學習和分類。
model = tf.keras.models.Sequential([
  tf.keras.layers.Flatten(input_shape=(28, 28)),
  tf.keras.layers.Dense(128, activation='relu'),
  tf.keras.layers.Dense(10, activation='softmax')
])
Step 5. 模型編譯與訓練
- 編譯模型:在訓練之前,需要編譯模型,設置優化器、損失函數和評估指標。本篇文章將使用 Adam 優化器,
sparse_categorical_crossentropy作為損失函數,並追踪其準確率來做為評估指標。
model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
metrics=['accuracy'])- 訓練模型:使用
fit方法來訓練模型,並且使用前面準備的圖像訓練數據來訓練模型,過程中模型將學習如何將輸入的訓練圖像映射到輸出類別,這就是監督式學習的基本概念。這裡設定迭代 5 個訓練週期,讀者可以根據自己需求調整訓練週期並觀察模型訓練效果。
model.fit(training_images, training_labels, epochs=5)Step 6. 模型儲存與載入
備註:本步驟提供有需要練習儲存模型的讀者參考,若不需要則可以考慮跳至下一個步驟,不會影響本專案學習。
- 儲存模型:訓練完成後,我們可以將模型儲存起來,以便未來使用或進行進一步的分析。
model.save('fashion_mnist_model.h5')- 載入模型:若要使用這個儲存的模型時,可以使用下列程式碼載入之前儲存的模型來使用。
loaded_model = tf.keras.models.load_model('fashion_mnist_model.h5')Step 7. 模型評估與優化
- 評估模型性能:使用測試數據集來評估模型的準確度,以了解模型在處理未見過的數據時的表現。下面程式碼將輸出模型在測試集上的準確度,讓我們能夠評估其泛化能力(Generalization)。
test_loss, test_acc = model.evaluate(test_images, test_labels)
print(f"Test loss: {test_loss}")
print(f"Test accuracy: {test_acc}")
測試損失表示模型在測試數據上的平均損失值,測試準確率則表示模型正確預測標籤的比例。
- 性能優化:可以根據模型的表現,來調整模型結構(如增加層數、改變神經元數量)或調整學習參數(如學習率、批次大小),進行再次訓練和評估,以達到更好的性能。
Step 8. 檢視模型架構
備註:本步驟提供想了解神經網路結構的讀者參考,若不需要則可以暫時忽略此步驟,不會影響本專案學習。
- 檢視模型架構:若想要顯示模型的摘要資訊,可執行下面程式碼,將會顯示包括每層的名稱、輸出形狀和參數數量,對於理解模型的構造和複雜度非常有幫助。
model.summary()
- Model: “sequential”:表示我們所建立的模型是一個序列性模型(Sequential),這是最簡單的 Keras 模型類型,每一層就像是樂高積木一樣按順序一個接一個。
- Layer (type):顯示每層的類型,如
Flatten、Dense等。 - Output Shape:顯示每層的輸出形狀。例如
👉 flatten (Flatten) 是模型的第一層,將圖像從二維圖像(28×28像素)轉換為一維向量(784像素),輸出形狀是(32, 784),其中 32 是批次大小(batch size),784 是展平後的特徵數量。
👉 dense (Dense) 是模型的第二層,也是一個全連接層(Dense),它有 128 個神經元。
👉 dense_1 (Dense) 則是模型的第三層,也是一個全連接層,它有 10 個神經元,用於輸出模型對 10 個類別的預測。 - Param #:表示每層中訓練參數的數量。全連接層(Dense)的參數數量取決於前一層的輸出單元數和當前層的單元數。
👉flatten層的參數數量為0,因為它只做數據轉換,不包含任何需要訓練的參數。
👉 第一個dense層的參數數量是 100480,這是由 784(輸入單元)x 128(輸出單元)+ 128(bias 偏差值)計算得來的。
👉 第二個dense層的參數數量是1290,這是由 128(輸入單元)x 10(輸出單元)+ 10(bias 偏差值)計算得來的。 - Total params:顯示模型總共的參數數量,這裡是101770,表示模型中所有層的參數加起來的總數。
- Trainable params:顯示可訓練的參數數量,這裡與總參數數量相同,意味著模型中所有的參數都是可訓練的。
- Non-trainable params:顯示不可訓練的參數數量,在這個模型中沒有不可訓練的參數。
model.summary() 這個命令對於確認模型結構和調校非常有用,可以讓我們直觀地看到模型各層配置以及它們是如何連接的。而另一種方法則是將這個神經網路架構視覺化如下,也提供讀者參考。

3. 心得與結論
透過這個專案,初學者不僅能夠學習深度學習的理論知識,還能夠獲得實際操作經驗,對於理解和掌握深度學習的概念很重要。無論是從數據處理、建構模型架構到模型訓練及評估,每一步都是了解深度學習流程的重要組成部分。
此外,這個專案也可以讓讀者有機會練習調整模型參數(如學習率、層數、神經元數量等),這是優化模型性能的關鍵技能。讓學習者可以透過實驗不同的設定來觀察對模型性能的影響,這樣的實務經驗對於有興趣成為一名深度學習工程師非常重要,也是一個非常好的入門學習範例,適合大家透過實作及詳細介紹實際理解深度學習的基本原理和方法。
如果大家想要了解人工智慧、機器學習、深度學習、神經網路、生成式 AI 的相關基礎知識,可以參考這一本書《 「生成式⇄AI」:52 個零程式互動體驗,打造新世代人工智慧素養 》,或是 SimpleLearn|Online 課程,它將帶領讀者在不會程式、不會數學也OK!的情況下,了解整個 AI 到 生成式 AI 的相關觀念及應用,不僅可以建立最完整的 AI 入門知識,更是培養 AI 素養的最好學習內容。
如果你喜歡這篇文章歡迎訂閱、分享(請載名出處)與追蹤,並持續關注最新文章。同時 FB 及 IG 也會不定期提供國內外教育與科技新知。